Lara Mini Base: Translated allena un modello piccolo su 45 lingue ed è primo su 36
Il modello base dietro la traduzione offline di Lara ha 7,2 miliardi di parametri e ne usa 0,6 per token. Un terzo dei dati non è in inglese e, secondo Translated, batte gli altri 35 modelli aperti della sua classe. Pesi su Hugging Face, solo per uso non commerciale.
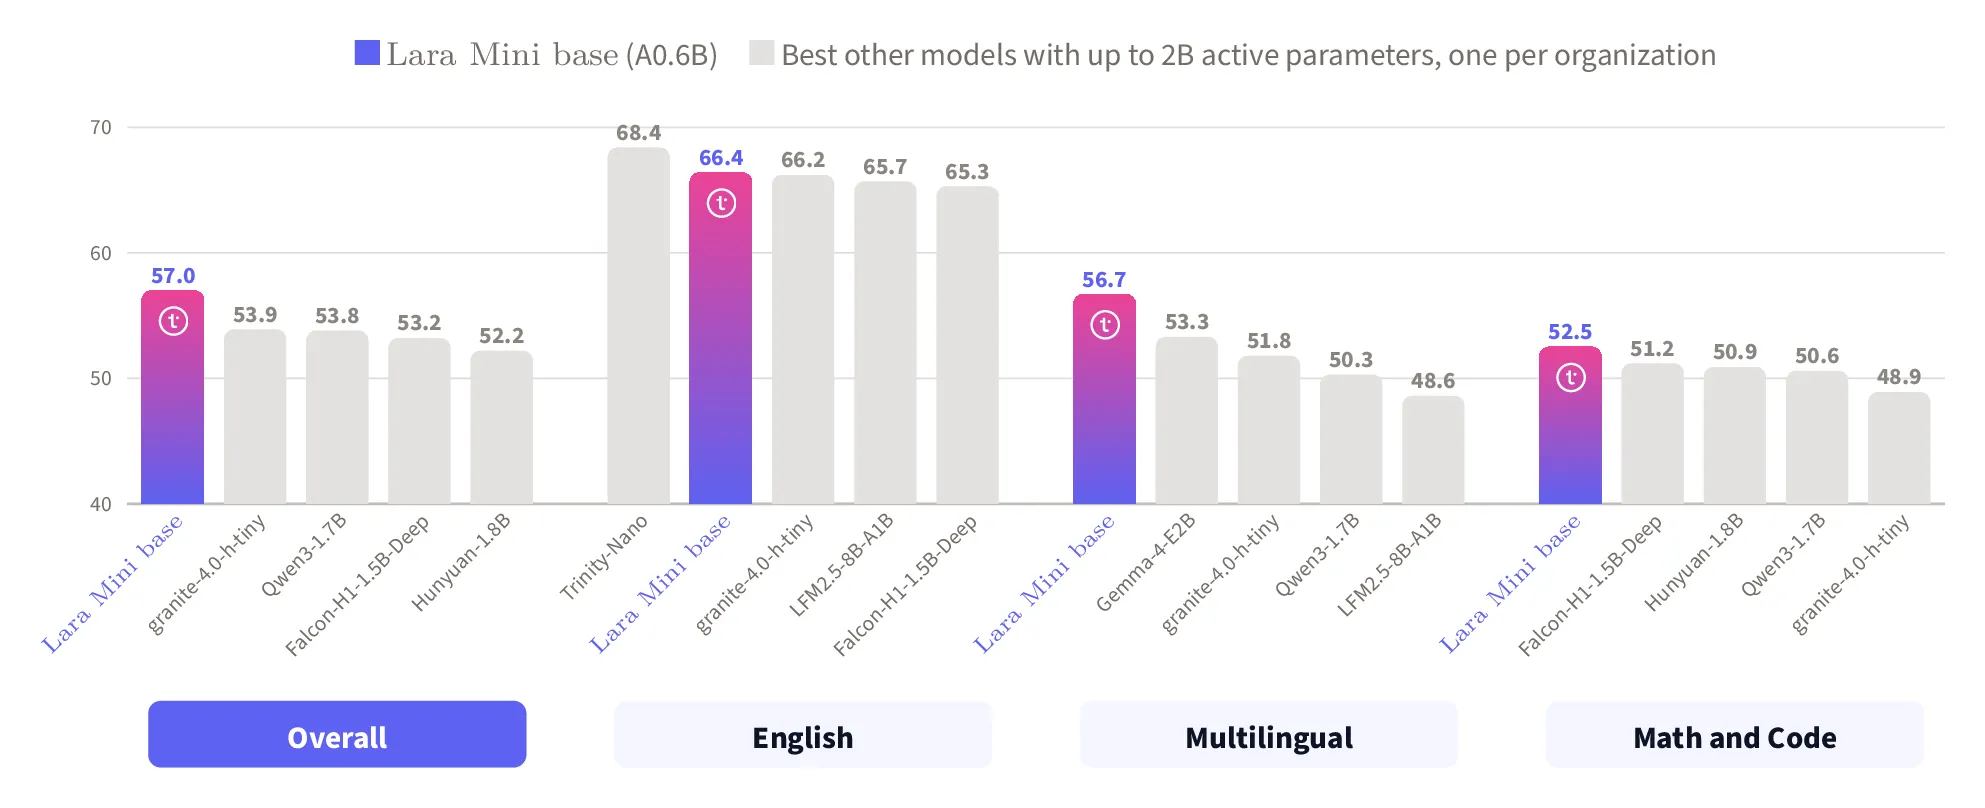
Translated, l’azienda che fa il traduttore Lara, ha pubblicato Lara Mini Base, un modello linguistico piccolo allenato fin dall’inizio su molte lingue: inglese più altre 44, che coprono tutte le 24 lingue ufficiali dell’Unione europea. Ha 7,2 miliardi di parametri, ma per ogni token ne attiva 0,6. Sui benchmark misurati da Translated ha la media più alta tra i 36 modelli aperti con al massimo 2 miliardi di parametri attivi: 57,0, tre punti sopra granite-4.0-h-tiny di IBM. Per chi scrive software i motivi di interesse sono due: un modello base che gira su un telefono e capisce l’italiano quanto l’inglese, e una ricetta di addestramento documentata fino al calendario del learning rate.
La scommessa sulle lingue
La pagina di ricerca apre con una tesi: “Every AI lab assumes more languages make a model worse. We bet the opposite.” Nel paper su arXiv Translated mette un numero dietro la prima metà della frase: nei modelli aperti che ha esaminato, i dati di pretraining non in inglese arrivano al massimo al 12%. I modelli costruiti apposta per le lingue europee ne usano molti di più, ma prendono punteggi ben più bassi dei modelli generalisti della stessa taglia. Il timore diffuso, scrive Translated, è che in un modello piccolo le lingue si contendano la stessa capacità.
Lara Mini Base è allenato su 6T token. Di questi, 2,49T sono in inglese e 2,18T nelle altre 44 lingue, quindi circa un terzo. Il resto è codice (0,77T), matematica (0,35T) e 0,21T di dati simili al fine-tuning supervisionato: domande e risposte, esercizi di matematica, esempi di codice. Secondo il paper, man mano che l’addestramento va avanti le altre lingue messe insieme superano l’inglese. Translated sostiene anche che l’architettura a esperti riduca la competizione tra lingue per la capacità del modello.
Il modello è nato come LLM generico sotto Lara 4, il sistema di traduzione dell’azienda. La pagina indica tre usi: la traduzione offline nella prossima app di Lara Translate, dove il testo resta sul telefono e ogni traduzione richiede meno di un secondo; una base da specializzare per alcuni clienti enterprise di Translated, con una latenza end-to-end sotto i 20 ms sul loro cloud; e l’accesso per i ricercatori che vogliono riprodurre i risultati.
Com’è fatto dentro
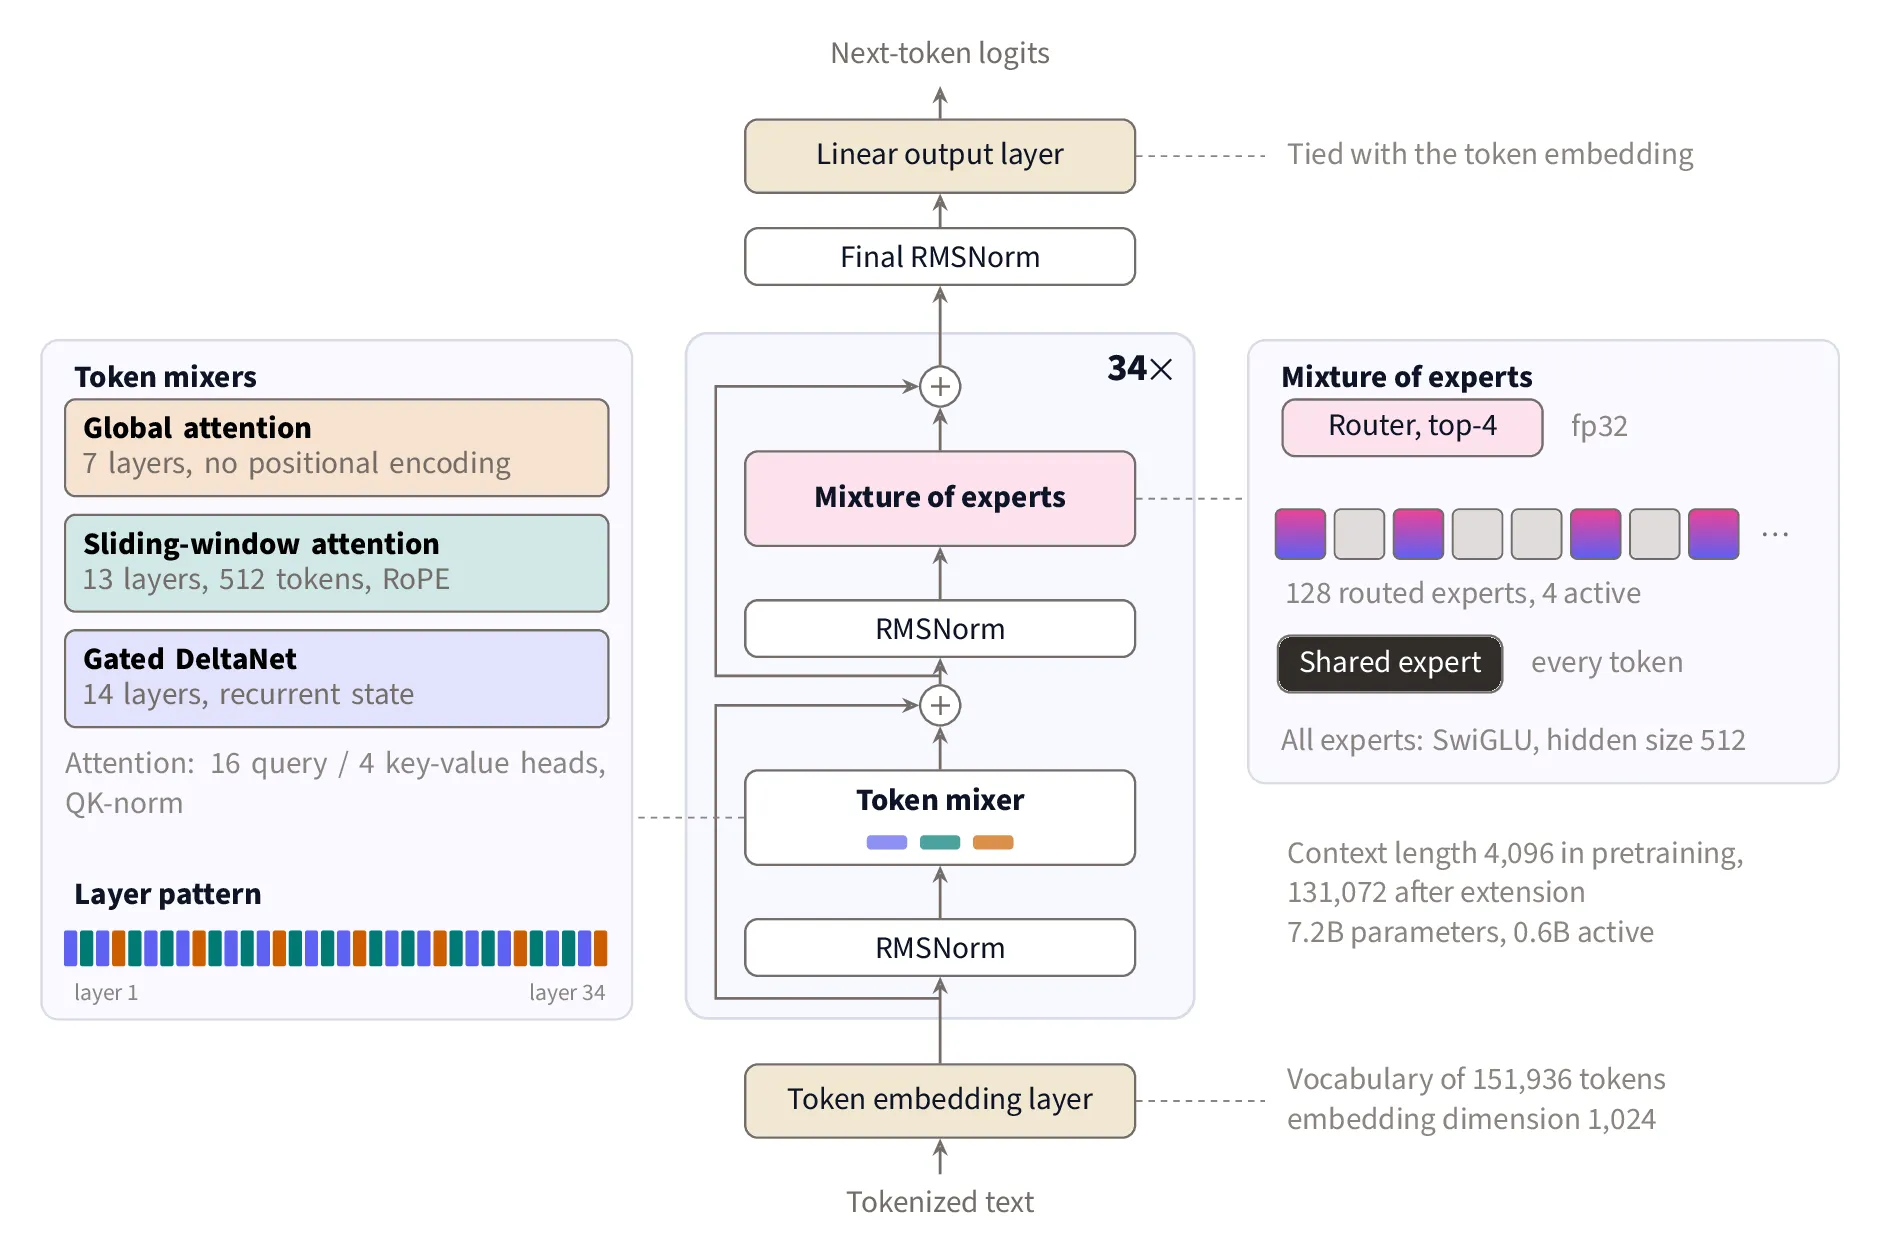
I 34 layer sono di tre tipi, ripetuti in uno schema fisso. 14 sono Gated DeltaNet (GDN), un’attenzione lineare che tiene uno stato per testa e lo aggiorna token per token. 13 usano l’attenzione su una finestra degli ultimi 512 token, con posizioni RoPE. 7 sono a attenzione globale, senza codifica della posizione, e l’ultimo layer è sempre globale. Solo questi 7 vedono tutto il contesto; gli altri hanno uno stato che non cresce con l’input, e per questo il contesto lungo occupa poca memoria.
In ogni layer c’è un mixture of experts: un router sceglie 4 esperti su 128 per ogni token, e un esperto condiviso è sempre acceso. Così su 7,2B parametri ne lavorano 0,6B per token, embedding compresi. La dimensione nascosta è 1.024, l’attenzione ha 16 teste di query e 4 di chiave-valore, il vocabolario conta 151.936 token secondo la model card (151.643 sulla pagina di ricerca) e gli embedding di input e output sono condivisi.
L’ottimizzatore è Muon per le matrici dei pesi e AdamW per il resto. Muon ortogonalizza ogni aggiornamento del momentum con il metodo di Newton-Schulz prima di applicarlo, così tutte le direzioni di una matrice si muovono a una velocità simile. Il learning rate di picco è 8e-4, il batch globale circa 8,4 milioni di token.
Come è stato addestrato
I dati vengono tutti da dataset pubblici, tra cui FineWeb-2, FineWeb2-HQ, HPLT 3.0, CulturaX, The Stack v3 e le raccolte Nemotron di NVIDIA. Translated li ha deduplicati e filtrati in un insieme di 13,8T token, scartando il 39% dei token grezzi; durante l’addestramento il modello ha letto 6T token, il 97% dei quali unici. Il web semplice non viene mai ripetuto, e nessuna fonte passa più di due epoche, salvo wiki e matematica di alta qualità. I dati di addestramento non vengono rilasciati.
L’addestramento ha tre fasi su sequenze da 4.096 token. La fase principale copre 4,8T token, fino all’80% del percorso. Una transizione di 0,6T sposta già metà della miscela verso quella finale, con più dati di qualità, domande e risposte, codice e matematica. L’anneal, gli ultimi 0,6T, usa la miscela migliore mentre il learning rate scende a zero. In ogni fase il multilingue resta intorno a un terzo. Un quarto stadio da 100B token, con sequenze da 32.768 e poi 131.072 token, porta il contesto a 128K.
I numeri, e chi li ha misurati
Tutti i punteggi sono di Translated. L’azienda ha valutato Lara Mini Base e 56 modelli base aperti con lo stesso strumento, lm-evaluation-harness, gli stessi prompt e le stesse correzioni sul formato delle risposte. I benchmark sono 26: 10 in inglese (tra cui MMLU, MMLU-Pro, HellaSwag e ARC-Challenge), 9 multilingue (tra cui XNLI, Belebele e Global MMLU), 3 di matematica (GSM8K, MATH, MGSM) e 4 di codice (MBPP, MBPP+, CRUXEval-I e CRUXEval-O). La media generale pesa un quarto ciascuno inglese, multilingue, matematica e codice. I benchmark multilingue sono mediati sulle 44 lingue su cui Lara è stato allenato, per tutti i modelli. La fase di anneal ha scartato le sequenze che contenevano item dei benchmark.
Nella classe fino a 2B parametri attivi, Lara Mini Base fa 57,0. Seguono granite-4.0-h-tiny (53,9, allenato su 22,5T token), Qwen3-1.7B (53,8, su 36T), Falcon-H1-1.5B-Deep (53,2) e Hunyuan-1.8B (52,2). Gemma-4-E2B di Google, contato alla sua taglia effettiva di 2B, è diciassettesimo con 41,9. Per dominio, Lara è primo nel multilingue (56,7) e in matematica (59,9), secondo in inglese (66,4, dietro Trinity-Nano a 68,4) e quinto nel codice (45,1). Tra i nove modelli europei della stessa classe il distacco è di 16 punti sul secondo, Bielik-1.5B-v3.
Sul contesto lungo i risultati sono meno netti. Su RULER a 128K token fa 63,7, sopra Trinity-Nano e granite, ma sotto Qwen3.5-2B (73,8) e Gemma-4-E2B (71,0). Su ONERULER, il test di recupero in 26 lingue, a 32K è il migliore della tabella con 90,1.
Sulla velocità Translated ha misurato 45 modelli su una A100, in bf16 e senza quantizzazione, contando i caratteri al secondo per non favorire i tokenizer più densi. Lara Mini Base genera circa 1.100 caratteri al secondo per un singolo utente, e ogni modello con una media più alta è almeno 1,8 volte più lento.
Come provarlo e cosa si può farci
I pesi sono su Hugging Face come translated/Lara-4-Mini-Base. Il repository è pubblico, ma per scaricare i file bisogna indicare nome e affiliazione, e ogni richiesta viene approvata a mano dal team. La licenza è CC BY-NC-SA 4.0: uso non commerciale, citazione, e le versioni modificate vanno distribuite con la stessa licenza. Codice e tokenizer sono sotto Apache 2.0. Per l’uso commerciale Translated si dice disponibile a licenze diverse, da chiedere a research@translated.com.
L’esempio della model card usa transformers:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

path = "translated/Lara-4-Mini-Base"
tokenizer = AutoTokenizer.from_pretrained(path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(path, trust_remote_code=True, dtype=torch.bfloat16, device_map="cuda")

inputs = tokenizer("La Divina Commedia è un poema scritto da", return_tensors="pt").to(model.device)
out = model.generate(**inputs, max_new_tokens=32, do_sample=False)
print(tokenizer.decode(out[0], skip_special_tokens=True))
Serve transformers 5.14 o successivo (testato fino alla 5.22.2). Con flash-linear-attention installato i layer GDN usano kernel veloci su GPU; senza, il percorso in PyTorch puro dà gli stessi risultati ma è lento sugli input lunghi. Il modello è stato allenato senza token BOS, e il tokenizer non lo aggiunge. Per il fine-tuning va caricato con output_router_logits=True, così la loss include il bilanciamento del router (coefficiente 0,001, come nel pretraining).
I limiti
È un modello base: continua il testo che riceve. Non segue istruzioni, non regge una conversazione e non ha tuning di sicurezza, quindi può produrre testo sbagliato, distorto od offensivo. Oltre i 131.072 token il comportamento non è testato. Una parte dei dati sintetici di NVIDIA è stata generata con modelli Qwen e DeepSeek, e la model card riporta le condizioni delle loro licenze: tra queste, il divieto di usare Lara Mini Base e i suoi derivati per gli usi elencati nell’Allegato A della licenza DeepSeek, da trasmettere a chi li riceve.
Il report tecnico completo si chiede con un modulo sulla pagina; su arXiv c’è il paper di 51 pagine, firmato da Translated e altri 205 autori.
Il piano: si va avanti solo con una medaglia
Translated ha diviso i prossimi modelli in tre gare con una regola: allena lo stadio successivo solo se vince una medaglia in quello in corso. Il primo stadio è la categoria piccola (meno di 2B attivi), con Lara Mini Base ora e Lara Mini a dicembre 2026. Il secondo è Lara Piccola Base, 138B parametri con 6,7B attivi, prevista per marzo 2027: la pagina stima 20T token, 30 giorni su 512 GPU H100 e un costo di circa un milione di dollari, con l’obiettivo di battere Gemma 4 31B sul multilingue. Il terzo è Lara Grande Base, 1,2T parametri con 60B attivi, per dicembre 2027; il modello Lara Grande che ne deriva, a marzo 2028, secondo Translated dovrebbe avvicinarsi ad Anthropic e OpenAI. Date e costi vengono dal piano di budget dell’azienda del 3 novembre 2026.