Gemini 4 Hydrogen: il modello veloce di Google per i passi di routine degli agenti
Google aggiunge alla famiglia Gemini 4 un modello da 1,50 dollari per milione di token in input, pensato per eseguire: scrivere codice, lanciare test, chiamare tool. In Antigravity arriva Orchestrator, che lo alterna a Carbon nella stessa sessione.
Il 12 novembre Google ha rilasciato Gemini 4 Hydrogen (gemini-4-hydrogen), il modello della famiglia Gemini 4 pensato per l’esecuzione veloce: scrivere codice, lanciare test, verificare modifiche, chiamare tool. Costa 1,50 dollari per milione di token in input e 7,50 in output, con prezzo piatto su tutto il contesto da 1 milione di token, ed è disponibile anche nel free tier della Gemini API. Secondo Google, all’impostazione predefinita high fa 51 sull’Artificial Analysis Intelligence Index, uno in più di Gemini 4 Argon, e su Terminal-Bench 4.1 passa dal 18,2% di Gemini 3.8 Flash al 57%. Google lo propone a chi costruisce agenti come esecutore da affiancare ai modelli più costosi, e in Antigravity lo fa già in automatico con Orchestrator.
Dove si colloca nella famiglia Gemini 4
Nella documentazione della Gemini API, Gemini 4 Carbon è il modello di frontiera più forte, per architettura, debugging difficile e audit di sicurezza; Argon copre gran parte dei compiti lunghi con meno token. Hydrogen è “veloce ed efficiente” per coding quotidiano, app web interattive, agenti che usano tool, documenti multimodali ed esecuzione parallela di subagent, ed è l’aggiornamento consigliato per chi usa Gemini 3.8 Flash e i precedenti modelli Gemini 3 e 2.5. Gemini 3.5 Flash-Lite resta l’opzione più economica per classificazione e routing ad alto volume.
La model card precisa che Hydrogen è “adattato da Gemini 4 Carbon”: architettura, dati di addestramento e hardware sono rimandati alla scheda di Carbon. Il knowledge cutoff è marzo 2026. Gli input sono testo, immagini, audio, video e PDF; l’output è solo testo. Supporta function calling, structured outputs, code execution, computer use e grounding con Google Search e Google Maps; non supporta la Live API né la generazione di immagini o audio.
Come si usa dall’API
Il modello risponde sia su GenerateContent sia sulla Interactions API. L’esempio minimo della documentazione, in Python:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)
print(interaction.output_text)
Il parametro che conta di più è thinking_level, dentro generation_config. I valori sono low, medium, high (predefinito) e il nuovo xhigh. Google consiglia di partire da high e riservare xhigh ai problemi difficili e a più passi dove high non basta, avvertendo che aumenta latenza e token e può portare a “overthinking” sui prompt semplici. Suggerisce di valutare tutti e quattro i livelli e tenere il più basso che basta.
interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)
Il contesto da 1.048.576 token è unico e condiviso tra input, ragionamento e output. Una singola richiesta sincrona, in streaming o no, produce al massimo 65.536 token. Per andare oltre si imposta background a true e max_output_tokens sopra 65.536, fino a 1.048.576 meno i token di input: il server continua a blocchi da 64K mentre il client fa polling. Senza max_output_tokens, anche in background l’output si ferma a 65.536 token. In alternativa gli SDK più recenti offrono la continuazione lato client.
Cambia anche il default di Managed Agents: l’agente Antigravity (antigravity-preview-09-2026 negli esempi) ora usa Hydrogen come modello sottostante, configurabile con agent_config.
Prezzi e limiti
Sul piano a pagamento i prezzi sono uguali su tutto il contesto:
- input: 1,50 dollari per milione di token;
- input in cache: 0,075 dollari per milione, cioè il 95% di sconto della cache implicita, che scatta da sola sui prompt di almeno 4.096 token;
- output, token di ragionamento inclusi: 7,50 dollari per milione;
- grounding con Google Search: fatturato a parte, per query.
Il free tier è gratuito ma con limiti di frequenza. Google fattura ogni token elaborato, compresi quelli di ragionamento e, con il grounding, le istruzioni di sistema interne. La model card aggiunge tra i limiti noti allucinazioni, possibili lentezze o timeout e un consumo di token maggiore ai livelli di ragionamento più alti.
Cosa cambia per chi migra da Gemini 3.8 Flash
La checklist ufficiale ha alcuni punti che rompono il codice esistente se ignorati:
- il model ID passa da
gemini-3.8-flashagemini-4-hydrogen; - 3.8 Flash aveva budget separati (1M input, 64K output), Hydrogen ha il contesto unificato: vanno tolti o alzati a 65.536 i limiti bassi di
max_output_tokensscritti a mano, come 8.192; - il livello predefinito è
highe non piùmedium, eminimalrestituisce errore; - la cache esplicita (
cachedContents,caches.create) non è supportata: i campicached_contentvanno rimossi; temperature,top_petop_kvanno tolti: i valori nel range vengono ignorati, quelli fuori range danno un errore400;- niente tool call in JSON testuale chiesto via system prompt senza tool dichiarati, che può produrre
MALFORMED_FUNCTION_CALL: servono function calling nativo o structured outputs; - nelle conversazioni multi-turno va conservato
previous_interaction_id, o restituite intatte le thought signature, senza copiarne una su più partifunctionCallparallele.
Chi usa già Carbon o Argon non deve cambiare lo schema delle richieste. Le differenze sono il livello predefinito (Carbon e Argon partono da medium e arrivano al massimo a high) e i blocchi non in streaming da 65.536 token contro i 32.768 delle chiamate REST di Carbon e Argon. Nella stessa sessione si possono mandare i turni di pianificazione a gemini-4-carbon e quelli di esecuzione a gemini-4-hydrogen.
Orchestrator in Antigravity
Orchestrator è una nuova voce nel selettore dei modelli di Google Antigravity. Secondo il blog di Antigravity, i router statici che assegnano tutto il task a un modello in base al primo prompt non reggono sugli agenti che girano a lungo. Orchestrator invece passa da un modello all’altro dentro la stessa traiettoria: Carbon parte in una fase di sola lettura per esplorare le dipendenze e scrivere un piano con condizioni esplicite di ripianificazione, Hydrogen esegue modifiche, aggiornamenti di pacchetti e test, e quando incontra un ostacolo restituisce il controllo a Carbon. Secondo Google, ottiene tassi di successo vicini a Carbon da solo consumando in media il 24% di quota in meno e finendo il 19% più in fretta.
È disponibile come Orchestrator (Carbon) e Orchestrator (Argon) per gli abbonati Google AI Ultra, come Orchestrator (Argon) per Google AI Pro, e per le aziende tramite Gemini for business. Chi vuole decidere da sé quale modello fa cosa può collegare Hydrogen e Carbon con l’Antigravity SDK.
Come sono stati misurati i numeri
Tutti i numeri vengono da Google. Nella tabella pubblicata con l’annuncio Hydrogen è davanti a Claude Sonnet 5.5 e GPT-6.1 Terra su SWE-sweep (13,5% contro 3,1% e 5,8%), Agents’ Last Exam v1.1 (71,6%), AutomationBench-AA (76,1%), Vending-Bench 2 (14.549 dollari di saldo finale), MKA (53,4%), Chartography (66,6%) e HLE-Diamond (58,8%). È dietro Sonnet 5.5 su Terminal-Bench 4.1 (57,0% contro 63,9%), OSWorld-2.1 nel sottoinsieme offline (77,6% contro 83,9%) e Terminal-Bench-Science 0.1 (51,4% contro 59,9% e 58,3%).
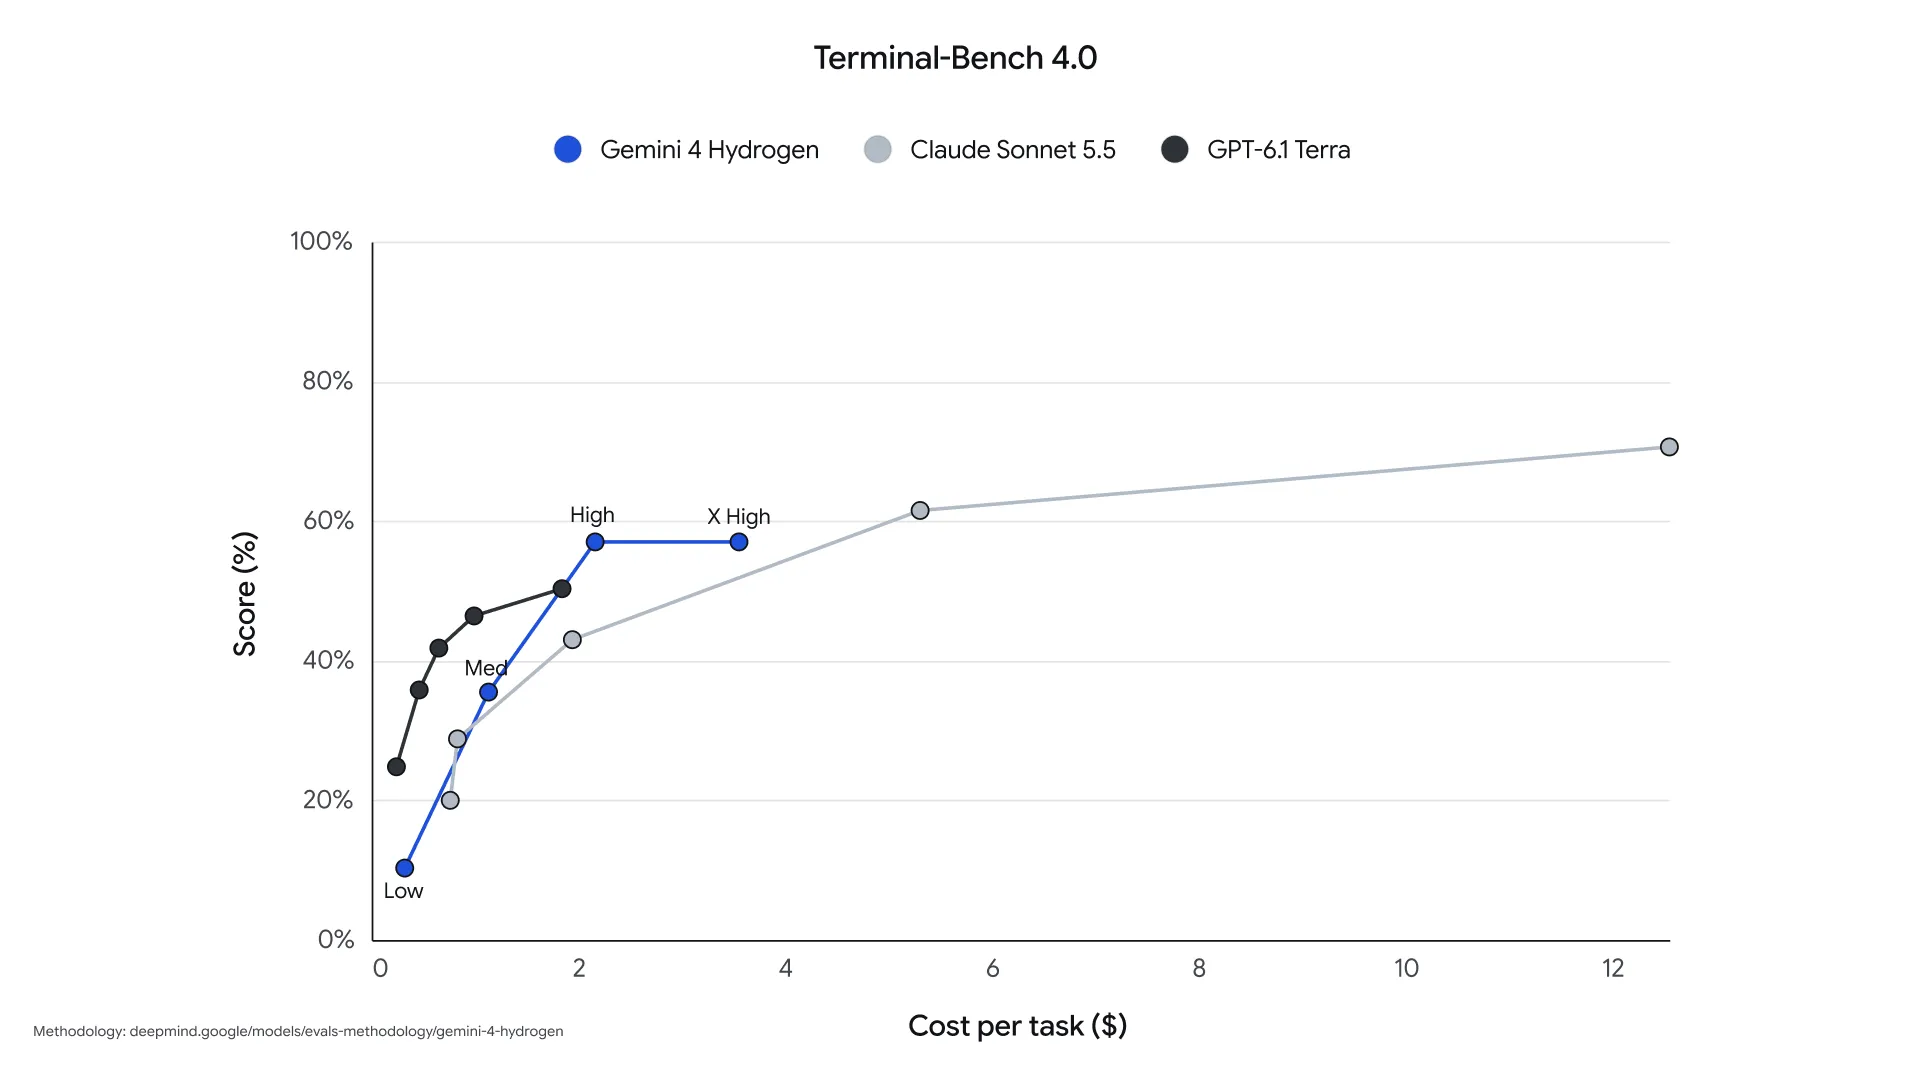
Il documento di metodologia di Google DeepMind dice che i punteggi sono pass@1 e ottenuti, salvo eccezioni, al livello di ragionamento più alto; Terminal-Bench è eseguito invece a high, con un harness mini-swe-agent e la media di 5 tentativi per task. SWE-sweep e Agents’ Last Exam usano Antigravity CLI 1.4.8. I risultati dei modelli concorrenti sono per lo più quelli dichiarati dai rispettivi produttori o presi dalle classifiche pubbliche. I grafici costo-punteggio usano Terminal-Bench 4.0 perché, spiega Google, per la 4.1 mancavano dati dei concorrenti a tutti i livelli di ragionamento. Sul grafico di Terminal-Bench 4.0 xhigh non migliora high: entrambi sono intorno al 57%, ma xhigh costa per task circa 3,5 dollari contro circa 2. Sull’indice di Artificial Analysis invece xhigh sale da 51 a 54, e il tempo per task passa da circa 6 a circa 13 minuti.
Cosa resta poco chiaro
Il blog di Google attribuisce il risultato di Orchestrator (-24% di quota, -19% di tempo) a Terminal-Bench 4.0, quello di Antigravity a Terminal-Bench 4.1; nessuno dei due dice quanto sia “vicino” il tasso di successo rispetto a Carbon. Google dichiara anche che Hydrogen riduce di oltre 5 volte le affermazioni inventate rispetto a 3.8 Flash e che i partner hanno visto tempi da 2 a 2,8 volte più rapidi con il 12-23% di token in meno, ma senza descrivere i test. Nella model card i rifiuti ingiustificati salgono di 5,57 punti rispetto a 3.8 Flash, soprattutto sui prompt multimodali. Il Safety & Security Report completo è annunciato come “in arrivo”.