Workflow · AI Hero · Approfondimento
The Home Repo Pattern: una repo con skill e AGENTS.md che punta a tutte le altre
Quando un prodotto è diviso in tante repo, l'agente di coding ne vede una sola. Matt Pocock (AI Hero) propone una Home Repo con skill, AGENTS.md e documenti condivisi, più una riga per ogni altra repo. La guida include un prompt di setup; con Claude Code cambiano alcuni dettagli su CLAUDE.md e skill.
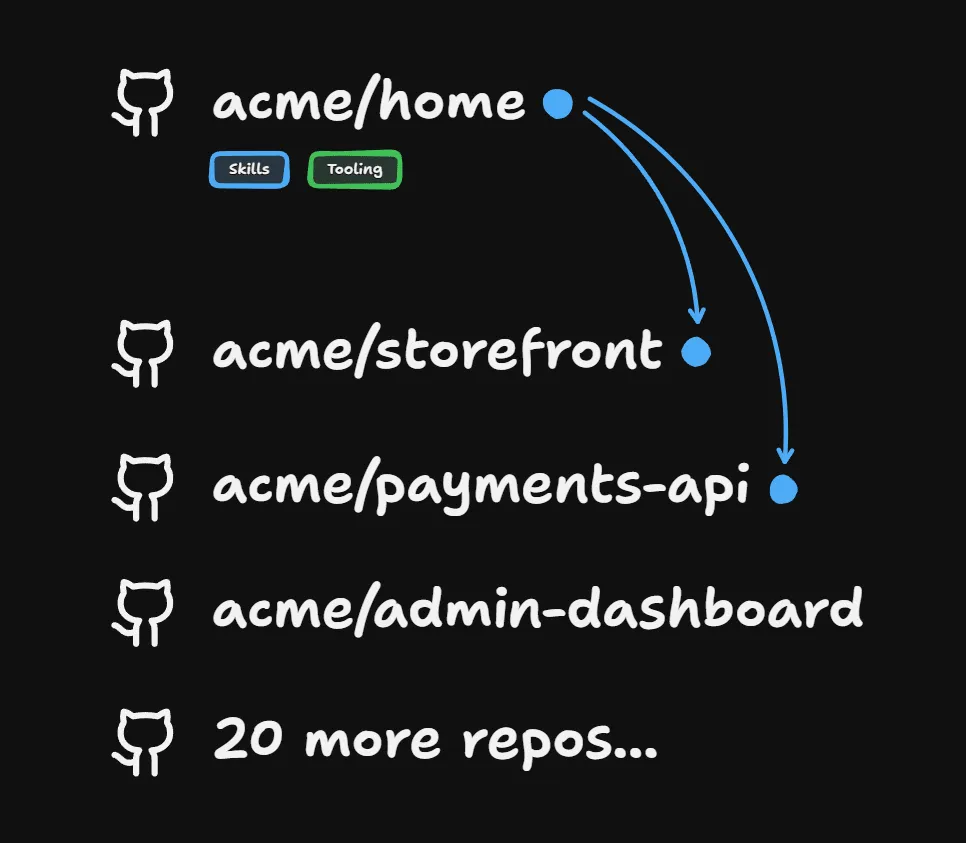
Quando un prodotto vive in più repository, un agente di coding avviato in una di esse vede solo quella: ogni repo ha la sua copia delle skill e del setup dell’agente, le copie divergono, e una feature che attraversa più repo si progetta senza visione d’insieme. Matt Pocock, su AI Hero, ha pubblicato il 12 novembre 2026 una guida a quello che chiama Home Repo Pattern: una repository senza codice di prodotto, che tiene le skill, l’AGENTS.md e i documenti condivisi e ha un puntatore verso ciascuna delle altre repo. Secondo l’autore il modello regge bene fino a circa 20 repo con un puntatore per riga, e scala oltre con qualche accorgimento. La guida include un prompt di setup da incollare nell’agente.
Che cos’è una Home Repo
Pocock la definisce come una repo che contiene le tue skill, il tuo AGENTS.md e i tuoi documenti condivisi, e che punta alle altre repo. L’agente si avvia lì e apre o clona le altre repo quando servono.
Tra i vantaggi cita un solo posto per i file di steering e il tooling, e anche per lanciare tutti gli agenti; le modifiche che toccano più repo si fanno da un’unica sessione.
Cosa va dove:
| Nella Home Repo | In ogni repo |
|---|---|
| Skill usate in più repo | Il codice della repo |
| AGENTS.md, con un puntatore per ogni repo | Il suo AGENTS.md, i comandi di build e test |
| Documenti condivisi: standard di codice, glossario, decisioni che valgono per tutto il sistema | I documenti che riguardano solo quella repo |
| Tooling, per esempio una CLI che collega l’agente a servizi esterni |
Secondo Pocock gli standard di codice sono il primo documento da condividere, perché un unico insieme si trasferisce da un progetto all’altro. Il codice invece resta dov’è, e ogni repo conserva storia, remote e issue tracker.
Come sono fatti i puntatori
Un puntatore è una riga per repo: il nome, dove si trova su disco e da dove clonarla se manca. Gli esempi della guida:
For skills, clone mattpocock/skills to ~/repos/skills.
For Sandcastle, clone mattpocock/sandcastle to ~/repos/sandcastle
Dove serve, si aggiunge un suggerimento per l’agente:
## Other Repos

Storefront (Next.js app): ~/repos/acme/storefront. Clone from git@github.com:acme/storefront.git if missing.
Payments API: ~/repos/acme/payments-api. Read its AGENTS.md before changing it.
AI Hero: ~/repos/ai/ai-hero (git pull to view latest, likely out of date)
Se la repo è già al percorso indicato, l’agente lavora lì; altrimenti la clona in quel punto. In alcuni setup le repo vengono clonate dentro la Home Repo e messe nel .gitignore. Le git submodules vanno bene con 5-10 repo, ma i puntatori fanno lo stesso lavoro senza.
Impostarla passo per passo
La guida fornisce un prompt da incollare in una nuova sessione dell’agente, avviata nella cartella che contiene le repo. Le regole: l’agente cerca da solo ogni fatto (filesystem, git, gh), con subagent per le ricerche ampie, e porta all’utente solo le decisioni, a turni, numerate e con una risposta raccomandata che un “sì” accetta; fino all’approvazione del piano legge soltanto; .env e gli altri file di segreti restano non letti.
- L’agente fa l’inventario delle repo: trova ogni repo git nella home, saltando le cartelle delle dipendenze, e per ciascuna registra percorso, remote, visibilità (pubblica o privata) e data dell’ultimo commit. Poi chiede quali repo includere (raccomanda quelle con commit recenti), dove creare la Home Repo (raccomanda una nuova repo privata accanto alle altre), se è personale o di team, e quale file carica l’harness all’avvio: AGENTS.md, CLAUDE.md o entrambi.
- Poi fa l’inventario del materiale condiviso. Nelle repo scelte e nelle cartelle di skill dell’utente, come
~/.claude/skills, elenca ogni skill (una cartella con unSKILL.md), ogni AGENTS.md e CLAUDE.md e ogni documento scritto per gli agenti: standard di codice, glossari, ADR. Ogni elemento va in un solo gruppo: shared (vale per tutte le repo), duplicate (in più posti: confronta le copie e segna la più recente), repo-specific (riguarda una sola repo), installed (da una repo di skill pubblicata o da un marketplace). - Per accordarsi sul piano, l’agente mostra una tabella con ogni elemento, dove si trova e dove andrà: shared e duplicate entrano nella Home Repo in un’unica copia, la più recente; repo-specific resta nella sua repo; installed resta installato. Sotto, la bozza dell’AGENTS.md della Home Repo: una breve introduzione e una sezione “Other Repos” con un puntatore per repo nel formato
<name> (<what it is>): <local path>. Clone from <remote> if missing.Oltre circa 20 repo, i puntatori vanno raggruppati in un file per area. - Approvato il piano, l’agente crea la Home Repo e il suo AGENTS.md; se l’harness carica un altro file, lo aggiunge come puntatore di una riga ad AGENTS.md. Copia dentro gli elementi condivisi, con le cartelle delle skill intere. In ogni repo figlia, su un nuovo branch locale, rimuove le copie spostate. Fa il commit nella Home Repo; il push resta all’utente. Alla fine riporta l’esito di ogni riga, i branch creati e cosa ha saltato, e perché.
Con Claude Code: CLAUDE.md, AGENTS.md e skill
La guida usa AGENTS.md ma dice di mettere i puntatori nel file che l’harness carica a inizio sessione, e ricorda che Claude Code carica CLAUDE.md. Secondo la documentazione di Claude Code, dalla v2.1.277 Claude Code legge direttamente AGENTS.md, ma solo quando nella cartella di lavoro e in quelle sopra non c’è un CLAUDE.md, un .claude/CLAUDE.md o un CLAUDE.local.md. Se c’è, il modo indicato dalla documentazione per tenere un solo file condiviso con gli altri agenti è un CLAUDE.md accanto ad AGENTS.md che lo importa:
@AGENTS.md
Corrisponde al “puntatore di una riga” che il passo 4 del prompt aggiunge quando l’harness carica un altro file.
Per le skill, Claude Code carica quelle di progetto da .claude/skills/<skill-name>/SKILL.md nella cartella di avvio e nelle cartelle superiori fino alla radice della repo: avviando la sessione nella Home Repo, le skill condivise sono quindi disponibili. La documentazione precisa anche cosa succede con le cartelle aggiunte via --add-dir: Claude Code ne carica le skill, ma non i CLAUDE.md, a meno di impostare una variabile d’ambiente:
CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 claude --add-dir ../shared-config
Un AGENTS.md letto direttamente non viene caricato dalle cartelle aggiunte nemmeno con quella variabile. Per le istruzioni delle repo figlie, quindi, il suggerimento esplicito nel puntatore che la guida propone (“Read its AGENTS.md before changing it”) fa il lavoro senza configurazione.
Lavorare tra più repo
Le sessioni partono dalla Home Repo, ed è lì che secondo Pocock si discute a fondo una feature che attraversa più repo. Per il lavoro in parallelo, ogni repo viene clonata una volta sola e ogni feature ha il suo worktree dentro quel clone, così più agenti possono lavorare sulla stessa repo contemporaneamente. L’agente raggiunge gli issue tracker di tutte le repo; lasciargli aprire ogni issue dove ha senso, scrive Pocock, funziona bene.
In un team si condivide la Home Repo, e tutti lanciano gli agenti da lì. Secondo Pocock l’ideale è che tutti usino le stesse skill, tenute nel progetto: ~/.claude/skills, la cartella utente, è un ripiego, mentre la Home Repo è versionata con git e si può condividere.
Fin dove scala
Circa 20 repo funzionano bene con un puntatore per riga. Intorno alle 400, scrive Pocock, un puntatore per repo diventa troppe scelte per l’agente, e serve la progressive disclosure: puntare a un file per area di business, che elenca le repo di quell’area.
## Other Repos

Billing (invoices, payments, tax): see repos/billing.md
Storefront (web and mobile apps): see repos/storefront.md
Internal tools: see repos/internal.md
Con migliaia di repo le skill hanno così tanti consumatori che, secondo l’autore, ha più senso un marketplace di skill.
Monorepo, tooling e CI
Un monorepo, quando lo si può avere, va bene; la Home Repo lo sostituisce quando non si può, per esempio con repo pubbliche e private insieme o con un team che non vuole adottarlo. Per partire non serve alcuna CLI: bastano i puntatori in AGENTS.md e gli strumenti già in uso. Più avanti può ospitare tooling, come una CLI verso servizi esterni, con le sue variabili d’ambiente. Funziona anche in CI: in una software factory la Home Repo sta nella sandbox e clona le altre repo quando servono.
Cosa resta aperto
La guida descrive un pattern e non fornisce strumenti: non c’è un formato standard per i puntatori né un modo automatico per tenerli aggiornati quando si aggiunge o si sposta una repo. Le soglie di 20 e 400 repo sono indicazioni dell’autore, senza misure pubblicate a sostegno.