Browser Use 1.0: via l'80% del codice, l'agente scrive Python dritto su Chrome
La 1.0 cancella 136.866 righe e cambia motore: invece di scegliere un'azione per volta da un DOM serializzato, l'agente scrive celle Python in un REPL persistente e le esegue su Chrome via DevTools Protocol. Cambiano anche i default: modello bu-fast, browser nel cloud, una sola chiave.
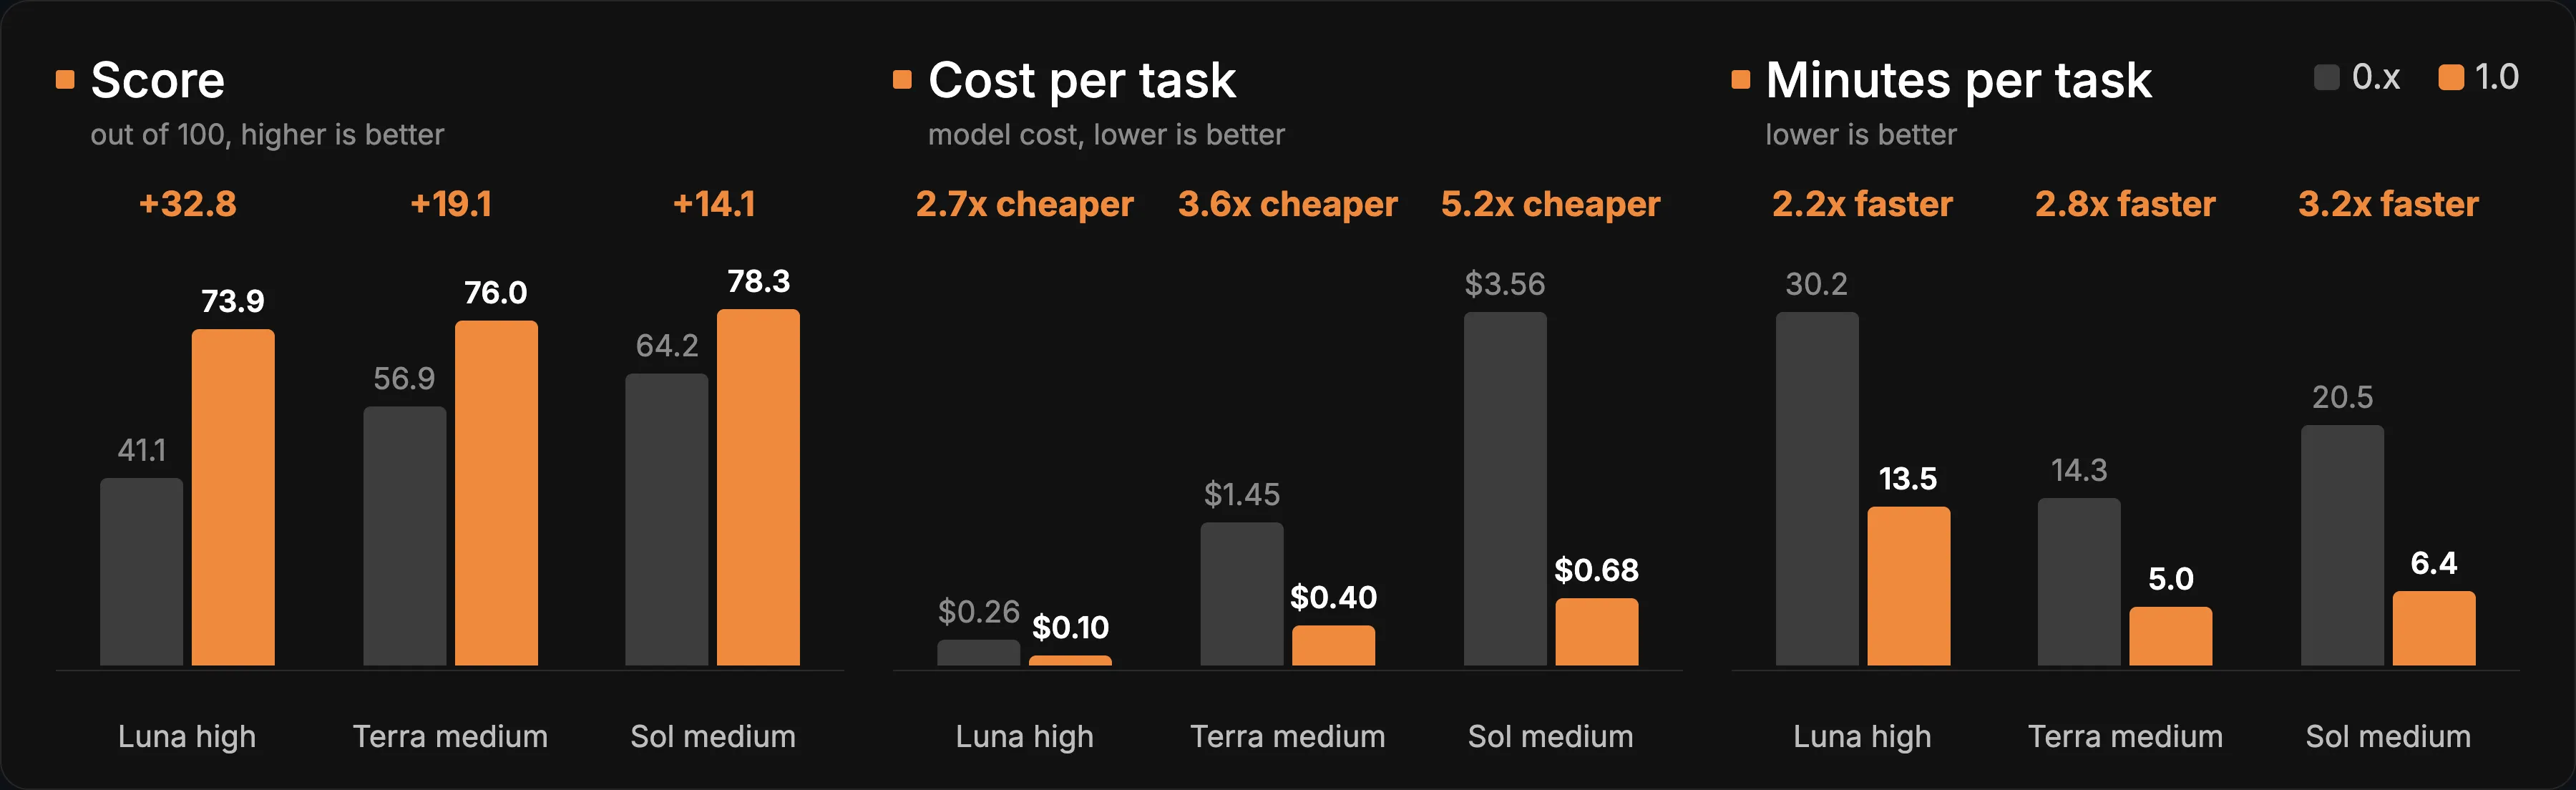
Il 10 novembre Browser Use ha pubblicato la versione 1.0.0 della sua libreria Python per agenti che usano il browser, e le note di rilascio partono da −136.866 righe: l’80% della libreria è stato cancellato e il motore riscritto da capo. Invece di ricevere una versione serializzata della pagina e scegliere un’azione per volta, l’agente scrive codice Python in un REPL che resta aperto per tutta la sessione e lo esegue direttamente su Chrome attraverso il Chrome DevTools Protocol (CDP). Secondo Browser Use, con gli stessi modelli il risultato è fino a 33 punti più alto, da 2,7 a 5,2 volte più economico e da 2 a 3 volte più veloce. Per chi ha già codice sulla 0.x cambiano anche i default: modello, browser e chiave.
Il motore della 0.x e quello della 1.0
Nella 0.x l’agente lavorava su un “DOM dump”: a ogni passo il modello vedeva la pagina tradotta in testo e sceglieva un’azione da uno schema fisso (navigare, cliccare, scrivere, estrarre). MIGRATING.md lo riassume così: “1.0 replaces the engine”. La 1.0 toglie sia il DOM serializer sia lo schema di azioni: il modello scrive una cella Python che usa gli helper di browser-harness e CDP grezzo, il REPL la esegue su Chrome e l’output torna al modello. Il ciclo, come lo disegnano le note di rilascio:
● task
│
● model writes a cell new_tab(url); bu.click(41); js(...)
│
● REPL runs it on Chrome (CDP) → output back to the model
│
✓ finish(result)
Sotto c’è Pydantic AI, che gestisce le chiamate al modello. Un passo corrisponde a una richiesta al modello: una cella Python, oppure la consegna finale. Quando una cella fallisce, il modello vede l’errore e riprova entro il limite di passi.
La superficie più usata della 0.x resta in piedi: Agent, Browser, Tools, run(), final_result(). Le azioni personalizzate restano funzioni con @tools.action('description'), ma ricevono solo i parametri che passa il modello.
Come si usa
Serve Python 3.11 o più recente. Dalle note di rilascio:
uv add 'browser-use==1.0.0'
export BROWSER_USE_API_KEY=bu_... # cloud.browser-use.com/new-api-key
from browser_use import Agent

print(Agent('Find the number of stars of the browser-use repo').run_sync().final_result())
Senza altri argomenti l’agente usa il modello bu-fast sul gateway di Browser Use e un browser di Browser Use Cloud, fermato a fine run. Secondo MIGRATING.md bu-fast è gpt-6-luna con reasoning medio; bu-ultrafast è lo stesso modello con reasoning basso sul tier prioritario, bu-smart un modello più grande. Una sola chiave paga modello e browser cloud e vale anche per la CLI e il server MCP: si imposta con BROWSER_USE_API_KEY o con browser-use login, che la salva in ~/.config/browser-harness/auth.json.
Per un browser locale e un modello proprio, dal README:
from browser_use import Agent, Browser, ChatOpenAI

agent = Agent(
    'Find the number of stars of the browser-use repo',
    llm=ChatOpenAI('gpt-6-luna'),        # OPENAI_API_KEY; or ChatOpenAI(model, base_url=...) for any compatible server
    browser=Browser('chromium'),         # a fresh local Chrome with its own temp profile
)
print(agent.run_sync().final_result())  # in async code: result = await agent.run()
I browser possibili sono quattro: Browser() (cloud, il default), Browser('chromium') (un Chrome/Chromium/Edge locale nuovo con profilo temporaneo, headless dove non c’è display come in Docker o CI), Browser('chrome') (il Chrome che hai aperto, con i tuoi login, dopo aver attivato chrome://inspect/#remote-debugging) e Browser('chrome', profile='Work') (un Chrome nuovo su una copia temporanea di quel profilo). Come modelli, oltre a ChatBrowserUse, ci sono ChatOpenAI, ChatAnthropic, ChatGoogle o qualsiasi stringa di modello Pydantic AI, per esempio llm='groq:llama-3.3-70b-versatile'.
Le funzioni nuove
- Risultati tipizzati con
Agent(task, output_model_schema=MyModel)e poiresult.structured_output. - Upload e download su browser locali e cloud: i file in ingresso vanno nel
workspace=, i download finiscono inworkspace/downloadse inresult.downloads. - I segreti passati con
sensitive_data=vengono digitati dal modello contype_secret()e sostituiti con<secret:name>nell’output delle celle, nei checkpoint, nei risultati dei tool e nel risultato finale. - Restrizioni di dominio (
allowed_domains,prohibited_domains,block_ip_addresses) con i pattern della 0.x, in ogni modalità di browser. - Ricerca web con
web_search=True, addebitata per ricerca sulla chiave Browser Use e sommata aresult.cost_usd. - La modalità
ultrafastagisce su id dell’accessibility tree: è il default conbu-fastebu-ultrafast,mode='default'la disattiva. - Per CLI e MCP:
browser-usepassa Python a browser-harness,browser-use --cli-mcpavvia il server MCP,browser-use skill installregistra la skill dell’agente.
Cosa cambia per chi aggiorna
La prima cosa da fare, dicono le note, è leggere MIGRATING.md, che elenca ogni opzione 0.x e la sua risposta nella 1.0. La regola generale: un’opzione che la 1.0 non può rispettare solleva un TypeError che la nomina prima che parta un browser o venga addebitato qualcosa. Le manopole di tuning della 0.x che non servono più (use_vision=True, flash_mode, max_failures e altre) danno un warning e vengono ignorate. Ogni import rimosso, dalla 0.1 alla 0.13, solleva un ImportError che indica il sostituto. I cambi di comportamento da controllare:
Browser()è un browser cloud: i task su localhost o IP privati richiedonoBrowser('chromium').Browser(local=True)ora vuol direBrowser('chromium').run(max_steps=...)scende da 500 a 100 di default, contimeout=1700secondi per il ciclo dell’agente.- Superati i controlli di configurazione,
run()non solleva più eccezioni: chiave o modello rifiutati, browser che non parte e fallimenti durante il run tornano comestatus='error'conresult.error. is_successful()èNonequando l’agente non dà un verdetto; per il comportamento della 0.x:r.is_done() and r.success is not False.errors()restituisce solo l’errore che ha chiuso il run.result.cost_usdcopre modello e ricerca web, non il browser cloud né il suo proxy.- I modelli del vecchio gateway (
bu-2-0,bu-1-0,bu-latest…) sono rifiutati; i modelli chat di LangChain dannoTypeError. - Spariscono pause/resume, replay della history, il judge, la GIF e le classi provider come
ChatAzureOpenAIoChatOllama, sostituite da stringhe Pydantic AI o daChatOpenAIconbase_url.
Chi vuole restare sulla vecchia versione: pip install 'browser-use<1'.
Come sono stati misurati i numeri
Il grafico delle note di rilascio confronta 0.x e 1.0 su tre modelli, chiamati “Luna high”, “Terra medium” e “Sol medium”. Il punteggio sale da 41,1 a 73,9, da 56,9 a 76,0 e da 64,2 a 78,3. Il costo del modello per task scende da 0,26 a 0,10 dollari, da 1,45 a 0,40 e da 3,56 a 0,68. I minuti per task passano da 30,2 a 13,5, da 14,3 a 5,0 e da 20,5 a 6,4. Il grafico non dice su quale benchmark né quante ripetizioni.
La tabella dettagliata riguarda un altro confronto: BU Bench v2, 60 task per 3 ripetizioni, browser cloud, il 9 novembre 2026, con la 1.0 in modalità ultrafast contro Browser Use Pi, l’agente TypeScript della stessa azienda. La 1.0 fa 62,5 punti [58,3, 66,5] a 0,070 dollari e 650 secondi per task; Pi 56,3 [50,2, 62,4] a 0,082 dollari e 743 secondi. Le note stesse avvertono che il distacco grezzo esagera: durante la finestra c’è stato un guasto di OpenAI, Pi ha perso 18 run su 180 per errori del provider, la 1.0 uno solo. Tolti quegli errori, la differenza di punteggio è +1,1 [−3,2, +5,7], non significativa; il costo scende di 0,013 dollari per task e il tempo di 114 secondi. Entrambi giravano su gpt-6-luna via api.openai.com, giudicati da gpt-5.6-luna (xhigh); bu-fast sul gateway non era nel test.
Prezzi e limiti noti
La libreria è gratuita e con licenza MIT; modelli e browser ospitati si pagano a parte. Il README indica il browser cloud a 0,02 dollari per ora-browser e ricorda che Browser('chromium') funziona anche con un modello locale, per esempio Ollama tramite ChatOpenAI con base_url='http://localhost:11434/v1'.
Le note elencano tre problemi aperti. Tutte le dipendenze sono fissate con == e il lockfile è nel repository: è una politica di supply chain, ma chi ha bisogno di un’altra versione di pydantic, pydantic-ai-slim, mcp, google-genai o pillow non può installare la 1.0 accanto. google-genai resta sotto la 3 finché Pydantic AI non la supporta. L’emulazione del viewport non funziona ancora sui browser cloud.
Sui segreti MIGRATING.md è esplicito: la redazione non è una sandbox. Il codice scritto dal modello gira come il tuo utente, può leggere i valori, i file che puoi leggere tu e l’ambiente degli altri tuoi processi; screenshot e live view mostrano quello che viene digitato. Anche le restrizioni di dominio sono “a guard for an aligned model, not a sandbox”: le richieste secondarie di una pagina permessa non vengono filtrate. Per task non fidati il consiglio è un container o una VM.